Paper Reading 1 :transformer
Transformer#
Transformer架构基于自注意力机制,能够高效地处理序列数据。它由编码器和解码器组成,广泛应用于自然语言处理和计算机视觉等领域。
前言#
在开始写这篇paper reading之前,作为一个初学者,我自己读了一下Transformer的原论文(幻觉翻译),感觉还是比较难懂的,所以我参考了一些博客和视频来帮助理解。
非常推荐的两个视频:
本篇blog的部分图片参考自上述第二个视频,已经询问过视频原作者了。
1.Transformer架构以及原理#
1.1.Transformer架构#
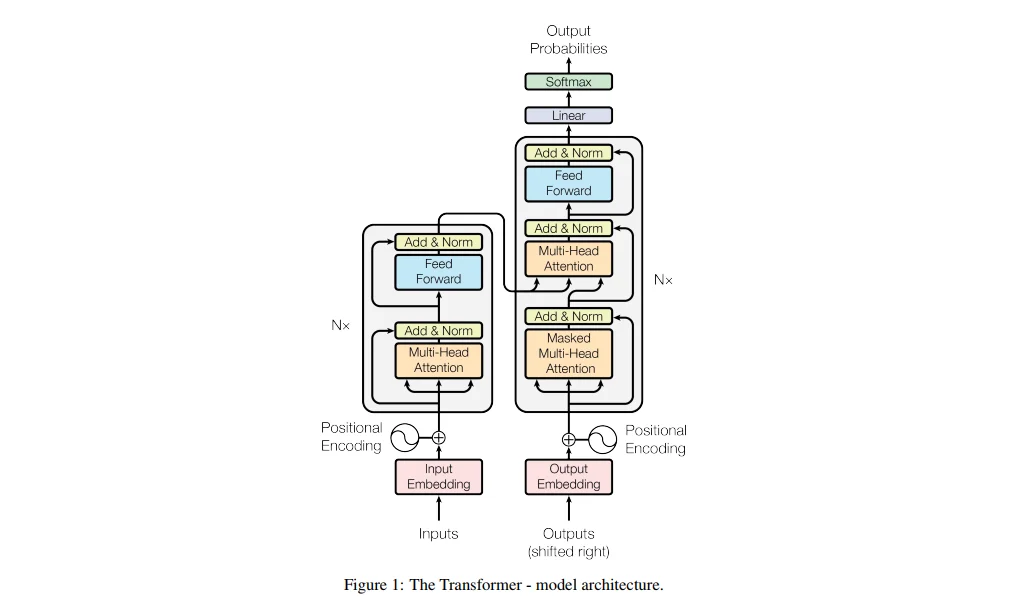
Transformer架构最初用于自然语言处理任务。Transformer的核心组件是自注意力机制(Self-Attention Mechanism),它允许模型在处理输入序列时动态地关注不同位置的信息。Transformer架构主要由编码器(Encoder)和解码器(Decoder)两部分组成,每部分包含多个相同的层(Layer)。每个编码器层包括多头自注意力机制(Multi-Head Self-Attention)和前馈神经网络(Feed-Forward Neural Network),而解码器层则在此基础上增加了对编码器输出的注意力机制。
1.2.缩放点积自注意力机制(Scaled Dot-Product Self-Attention)#
自注意力机制允许模型在处理序列数据时动态地关注不同位置的信息。它通过计算输入序列中每个位置与其他位置的相关性来生成新的表示。自注意力机制的计算过程包括以下几个步骤:
- 线性变换:将输入序列的每个token通过三个不同的线性变换映射到查询(Query)、键(Key)和值(Value)向量。
- 计算注意力分数:通过计算查询向量与键向量的点积来获得注意力分数,表示每个位置对其他位置的关注程度,通常会除以一个缩放因子以稳定梯度。
- 归一化:使用Softmax函数对注意力分数进行归一化,得到注意力权重。
- 加权求和:将值向量与注意力权重相乘并求和,得到新的表示。 缩放点积自注意力机制的数学表达式如下:
其中,、、分别表示查询、键和值矩阵,是键向量的维度。
在实际计算中,与的维度是,的维度是,最终输出的维度是。
1.3.多头自注意力机制(Multi-Head Self-Attention)#
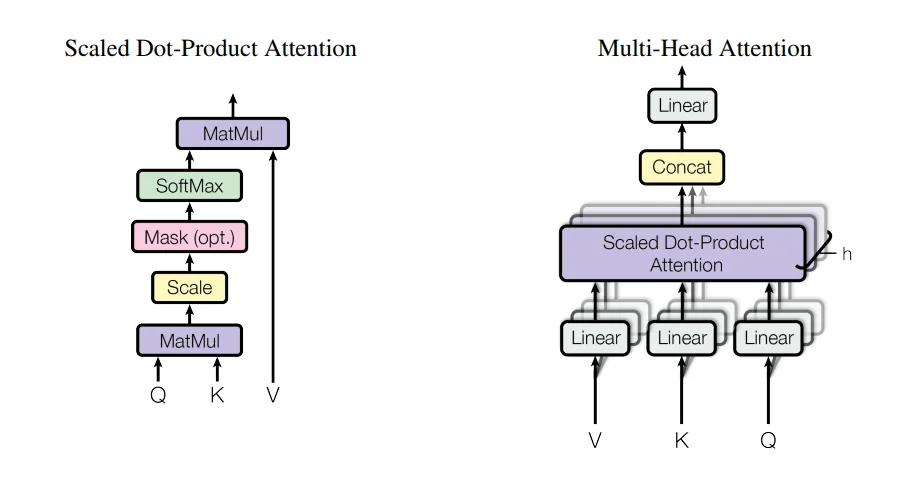
多头自注意力机制通过并行地计算多个自注意力头来增强模型的表达能力。每个头独立地学习不同的表示,然后将它们拼接在一起并通过线性变换得到最终的输出。
多头自注意力机制的数学表达式如下:
其中,表示头的数量,、、是每个头的线性变换矩阵,是输出的线性变换矩阵。
在使用多头自注意力机制时,最后的输出维度是通过拼接所有头的输出并进行线性变换得到的,因此需要确保每个头的输出维度之和等于模型的隐藏维度。于是这里维度相关的公式就是:
此次,是为了简化计算,实际中可以不相等。
1.4.位置编码(Position Encoding)#
由于Transformer架构不包含循环或卷积结构,因此无法直接捕捉序列中的位置信息。为了解决这个问题,Transformer引入了位置编码(Position Encoding),它为输入序列中的每个token添加了位置信息。位置编码可以是固定的(如正弦和余弦函数)或可学习的,论文中提到固定的与可学习的效果差不多,因此就采用了固定的位置编码。
表示位置,表示维度索引,是每个token的特征维度。
这里使用其中的2是为了区分偶数维和奇数维,偶数维使用正弦函数,奇数维使用余弦函数。这样设计的位置编码具有周期性,可以帮助模型捕捉不同位置之间的关系。
1.5层归一化(Layer Normalization)#
首先什么是batch normalization?Batch Normalization是特征归一化的一种方法,它通过对每个mini-batch的数据进行归一化处理,使得每个特征的均值为0,方差为1,从而减少了内部协变量偏移。Batch Normalization通常应用于卷积层或全连接层之后。
而Layer Normalization是另一种归一化方法,它对每个样本的所有特征进行归一化,使得每个样本的特征均值为0,方差为1,与Batch Normalization不同。Layer Normalization通常应用于Transformer中的自注意力机制和前馈神经网络之后。
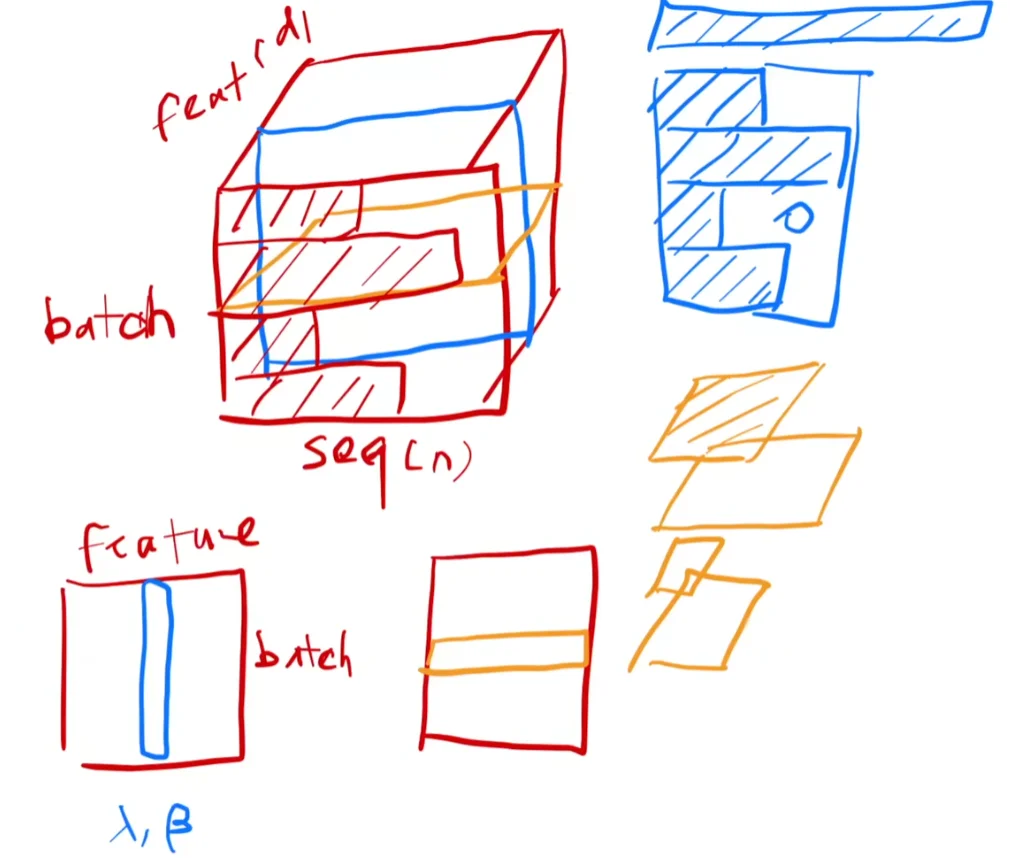
图中蓝色部分为Batch Normalization,橙色部分为Layer Normalization。下面是二维的例子,上面是三维的例子。
Layer Normalization更好的解释是,图中右侧部分的内容。Batch Normalization是对每个特征进行归一化,这个时候每个样本有长有短,而且在进行预测的时候需要存储全局的均值和方差,如果在进行预测的时候碰到一个非常长的样本,可能就处理不好。而Layer Normalization是对每个样本进行归一化,与全局的均值和方差无关。
2.Transformer例子(来自Second视频)#
假设我们有3个简单的句子,分别是:“史蒂夫 建造 房子”、“苦力怕 在 玩家 身边 爆炸”、“挖 钻石 很 有趣”。
2.1 输入嵌入(Input Embedding)#
首先将每个单词映射到一个高维向量空间中,每个单词映射为一个维度为的向量。

2.2 位置编码与编码器输入#
接下来,为每个单词添加位置编码,以便模型能够捕捉单词在句子中的顺序信息。与上文提到的公式相同,位置编码是通过正弦和余弦函数生成的。
位置编码的维度也是,然后将输入嵌入与位置编码相加(直接相加),得到编码器的输入表示。

Q: 将输入嵌入与位置编码相加,这会不会破坏原有的语义信息?
A: 它们最终会形成两个正交的子空间,可以分离出原有的语义信息和位置信息。通过训练,模型可以学习如何利用这些信息来进行任务。训练初期,他们确实不是近似正交的。词嵌入和位置编码在训练阶段初期,必然是会出现混淆,也破坏了语义。我们是通过损失函数和反向传播,不断的去迫使模型把位置的信息放到语义稀疏的维度上。迫使模型逐渐学会分离信息。但是注意,在训练后的,模型会逐步学会分离两者的关系,在高维空间中形成正交。所以正交性是通过训练实现的。
2.3 线性变换与查询、键、值向量#
在编码器中,每个输入表示会通过三个不同的线性变换映射到查询(Query)、键(Key)和值(Value)向量。具体来说,对于每个输入表示,我们有:,其中、、是可学习的权重矩阵。
2.4 多头自注意力机制#
多头自注意力机制允许模型在不同的表示子空间中并行地关注输入序列的不同部分。每个头独立地计算自注意力,然后将它们的输出拼接在一起,形成最终的表示。这里的每个头可以通过使用不同的线性变换矩阵来学习不同的表示,从而增强模型的表达能力。
 对于每个句子,可能有不同数量的单词,因此每个句子的长度可能不同。为了处理不同长度的输入,Transformer使用Padding Mask来忽略填充的部分,确保模型只关注实际的单词。具体做法是给Pad的位置加上一个很大的负数,从而在Softmax归一化后得到接近于零的权重。
自注意力分数的计算过程如下:


- 整体流程

2.5 残差连接与层归一化#
在每个编码器层中,Transformer使用残差连接(Residual Connection)和层归一化(Layer Normalization)来稳定训练过程。(见前文)
2.6 前馈神经网络#
每个编码器层还包含一个前馈神经网络(Feed-Forward Neural Network),它由两个线性变换和一个非线性激活函数(通常是ReLU)组成。前馈神经网络的作用是对每个位置的表示进行进一步的非线性变换,从而增强模型的表达能力。